এই পর্বে যা শিখবেন
- কেন পরিসংখ্যানের সংখ্যা দেখার আগে ডেটার ছবি দেখা দরকার, নিজে চালিয়ে প্রমাণসহ
- একটি matplotlib figure-এর ভেতরের বস্তুগুলো, আর pyplot বনাম object-oriented লেখার পার্থক্য
- line, bar, scatter আর histogram আঁকা; label, legend, limit, টাকার tick আর annotation বসানো
- কয়েকটি Axes একসঙ্গে সাজানো, pandas থেকে সরাসরি chart, style আর rcParams
- সঠিক format আর dpi-তে ছবি সংরক্ষণ, আর chart-এ বাংলা লেখার আসল অবস্থা ও কাজের সমাধান
১ · আগে দেখুন, তারপর মডেল — Anscombe-এর চারটি ডেটাসেট
মডিউল ৪-এ আপনি pandas দিয়ে বাজারঘরের অর্ডার পড়েছেন, পরিষ্কার করেছেন, জেলা ধরে যোগফল বের করেছেন (পর্ব ২৪)। সংখ্যাগুলো ঠিক আছে। কিন্তু একটি টেবিলের সংখ্যা দেখে কি ডেটার চেহারা বোঝা যায়? এই মডিউলের উত্তর: প্রায়ই যায় না। ডাক্তার শুধু থার্মোমিটারের একটি সংখ্যা দেখে রোগ ঠিক করেন না; রোগীকে দেখেন, প্রয়োজনে এক্স-রে দেখেন। ডেটার ক্ষেত্রে সেই এক্স-রে হলো chart.
এর সবচেয়ে বিখ্যাত প্রমাণ দিয়েছিলেন পরিসংখ্যানবিদ Francis J. Anscombe, ১৯৭৩ সালে The American Statistician পত্রিকায় “Graphs in Statistical Analysis” প্রবন্ধে। তিনি এগারোটি করে বিন্দুর চারটি ছোট ডেটাসেট বানালেন, যা এখন Anscombe's quartet নামে পরিচিত। চারটিরই x-এর গড় ৯, y-এর গড় প্রায় ৭.৫০, x-এর variance ১১, y-এর variance প্রায় ৪.১২, x আর y-এর correlation coefficient প্রায় ০.৮১৬, আর least-squares রেখা প্রায় y = ৩.০০ + ০.৫০০x. শুধু এই সারাংশ দেখলে মনে হবে চারটি একই ডেটা। মানগুলো প্রকাশিত আর ছোট, তাই নিচে হাতে লিখে দেওয়া হলো। চালিয়ে নিজে দেখুন:
Variance আর ddof=1 আপনি পর্ব ১৬-এ দেখেছেন; এখানে np.polyfit(xs, ys, deg=1) সবচেয়ে কাছের সরলরেখার ঢাল আর ছেদবিন্দু দেয়, আর np.corrcoef Pearson-এর r. এগুলোর তত্ত্ব আসবে পর্ব ৩৭-এ; এখন শুধু সংখ্যা মিলিয়ে নিন। এই পাতার প্রথম Python চালাতে কয়েক সেকেন্ড লাগতে পারে, কারণ ব্রাউজার NumPy আর matplotlib নামায়।
import numpy as np
import matplotlib.pyplot as plt

x = [10, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]          # Anscombe (1973)
quartet = {
    "I":   (x, [8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]),
    "II":  (x, [9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74]),
    "III": (x, [7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73]),
    "IV":  ([8, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8],
            [6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]),
}
print("set  mean_x mean_y var_x var_y    r   line")
fig, axes = plt.subplots(2, 2, figsize=(6, 4.4), sharex=True, sharey=True,
                         layout="constrained")
line_x = np.array([2, 20])
for ax, (name, (xs, ys)) in zip(axes.flat, quartet.items()):
    xs, ys = np.array(xs, dtype=float), np.array(ys)
    slope, intercept = np.polyfit(xs, ys, deg=1)      # least-squares line
    r = np.corrcoef(xs, ys)[0, 1]
    print(f"{name:4s} {xs.mean():6.2f} {ys.mean():6.2f} {xs.var(ddof=1):5.2f}"
          f" {ys.var(ddof=1):5.2f} {r:5.3f}  y = {intercept:.2f} + {slope:.3f}x")
    ax.scatter(xs, ys, s=22, color="tab:blue")
    ax.plot(line_x, intercept + slope * line_x, color="tab:orange", lw=1.2)
    ax.set_title(f"Set {name}", fontsize=10)
fig.supxlabel("x")
fig.supylabel("y")
fig.suptitle("Anscombe's quartet: same statistics, different data")
print("axes array:", type(axes).__name__, axes.shape)
plt.show()
ব্রাউজারে (Pyodide, matplotlib 3.10.8) আসল আউটপুট, নিচে ছবিসহ:
set  mean_x mean_y var_x var_y    r   line
I      9.00   7.50 11.00  4.13 0.816  y = 3.00 + 0.500x
II     9.00   7.50 11.00  4.13 0.816  y = 3.00 + 0.500x
III    9.00   7.50 11.00  4.12 0.816  y = 3.00 + 0.500x
IV     9.00   7.50 11.00  4.12 0.817  y = 3.00 + 0.500x
axes array: ndarray (2, 2)
চারটি সারির সংখ্যা দুই দশমিক পর্যন্ত প্রায় এক; শুধু তৃতীয় দশমিকে সামান্য তফাত। এবার ছবিগুলো দেখুন। Set I সত্যিই একটি সরলরেখার চারপাশে ছড়ানো বিন্দু; এখানে রেখাটি ঠিকঠাক বর্ণনা। Set II একটি মসৃণ বাঁক, প্রায় উল্টো U; সরলরেখা এখানে ভুল মডেল, বক্ররেখা লাগবে। Set III-এ দশটি বিন্দু প্রায় নিখুঁত একটি রেখায়, কিন্তু একটি outlier (১৩, ১২.৭৪) পুরো রেখাকে নিজের দিকে টেনে ঢাল বাড়িয়ে দিয়েছে। Set IV-এ দশটি বিন্দুর x একই, ৮; একটিমাত্র বিন্দু (১৯, ১২.৫০) না থাকলে correlation-এর হিসাবই করা যেত না, অথচ সেই একটি বিন্দুই r = ০.৮১৭ বানিয়েছে। কোডের দিক থেকে খেয়াল করুন: plt.subplots(2, 2) একটি (2, 2) আকারের NumPy array দিয়েছে, যার প্রতিটি ঘর একটি Axes, আর axes.flat সেগুলো একে একে দেয়। sharex=True, sharey=True চারটি ঘরের অক্ষকে একই পরিসরে বেঁধেছে, তাই চোখ দিয়ে তুলনা করা ন্যায্য।
সারাংশ পরিসংখ্যান ডেটাকে সংক্ষেপ করে, আর সংক্ষেপে তথ্য হারায়। গড়, variance আর r একই হলেও ডেটার আকার, outlier আর বাঁক আলাদা হতে পারে। তাই যেকোনো মডেল বানানোর আগে, এমনকি একটি সাধারণ linear regression-এর আগেও, ডেটার অন্তত একটি ছবি দেখা পেশাদার অভ্যাস। পুরো কাজের ধারা হিসেবে এটি আসবে পর্ব ৬২-এর exploratory data analysis-এ।
এই কাজের সবচেয়ে প্রচলিত টুল matplotlib. ২০০৩ সালের দিকে স্নায়ুবিজ্ঞানের গবেষক John D. Hunter মৃগীরোগীর মস্তিষ্কের সংকেত দেখার জন্য এটি লিখতে শুরু করেন, MATLAB-এর plot করার ধরন অনুকরণ করে; ২০০৭ সালে তিনি Computing in Science & Engineering-এ এর বর্ণনা প্রকাশ করেন। ২০১২ সালে তাঁর মৃত্যুর পর থেকে একটি স্বেচ্ছাসেবী দল প্রকল্পটি চালায়। আজ seaborn (পর্ব ৩০) আর pandas-এর .plot দুটিই matplotlib-এর ওপর তৈরি, তাই এর ভেতরটা বুঝলে বাকি সব সহজ হয়।
২ · একটি figure-এর ভেতরে — Figure, Axes, Axis আর artist
matplotlib-এর নামগুলো প্রথমে গোলমেলে লাগে, বিশেষ করে Axes আর Axis. একটি ক্রিকেট মাঠের স্কোরবোর্ডের কথা ভাবুন। পুরো বোর্ডটি একটি Figure. বোর্ডে কয়েকটি আলাদা প্যানেল থাকতে পারে, একটিতে রানরেট, আরেকটিতে ওভারপ্রতি রান; প্রতিটি প্যানেল একটি Axes, মানে নিজের অক্ষ, রেখা আর শিরোনামসহ একটি plot-এর ঘর। প্রতিটি প্যানেলের নিচের ওভারের দাগ আর বাঁ দিকের রানের দাগ দুটি Axis: XAxis আর YAxis. আর প্যানেলে আঁকা প্রতিটি জিনিস, রেখা, বার, লেখা, legend, এমনকি পেছনের সাদা আয়তক্ষেত্রটিও, একটি artist. Axes শব্দটি ইংরেজিতে axis-এর বহুবচনের মতো শোনায়, কিন্তু matplotlib-এ এর মানে একটি পুরো plot-এর ঘর; এই একটি তথ্য মনে রাখলে অর্ধেক বিভ্রান্তি কেটে যায়।
একটি matplotlib figure-এর গঠন
Anatomy of a figure: Figure → Axes → Axis → artists
এই গঠন শুধু নাম নয়, এটি আসল Python বস্তু। নিচের ধাপে একটি figure বস্তু ধরে ধরে তৈরি হচ্ছে। ডান দিকের মানগুলো লেখকের যন্ত্রে matplotlib 3.10.8-এ (পাতার ভেতরের Python-এর মতো একই সংস্করণে) প্রতিটি লাইনের পরে সত্যি মেপে নেওয়া: len(fig.axes) কতটি Axes, len(ax.lines) কতটি রেখা, ax.get_title() শিরোনাম, আর len(ax.get_children()) Axes-এর ভেতরে মোট কতটি artist.
1fig = plt.figure(figsize=(6, 3.5))2ax = fig.add_subplot()3ax.plot(week, dhaka, label="Dhaka")4ax.plot(week, khulna, label="Khulna")5ax.set_title("Weekly orders")6ax.set_xlabel("Week")7ax.legend()
| len(fig.axes) | |
| len(ax.lines) | |
| ax.get_title() | |
| ax.get_legend() | |
| children |
- শুধু ক্যানভাস।
plt.figureএকটি ফাঁকা Figure দিল, ৬ × ৩.৫ ইঞ্চির। এর ভেতরে এখনো কোনো Axes নেই, তাইfig.axesএকটি খালি তালিকা;axনামে কিছু এখনো তৈরিই হয়নি। - একটি Axes এলো।
add_subplot()ক্যানভাসে একটি plot-এর ঘর বসাল। রেখা নেই, শিরোনাম খালি, legend নেই, তবু ভেতরে ১০টি artist আগে থেকেই আছে: ৪টি spine, XAxis আর YAxis, শিরোনামের জন্য ৩টি Text (বাম, মাঝ, ডান) আর পেছনের সাদা Rectangle. - প্রথম রেখা।
ax.plotএকটি Line2D artist বানিয়ে Axes-এর তালিকায় যোগ করল; রেখা ১টি, artist ১১টি।label="Dhaka"এখনো কোথাও দেখা যাচ্ছে না, শুধু রেখার গায়ে লেখা আছে। - দ্বিতীয় রেখা। একই Axes-এ আরেকটি Line2D; রেখা ২টি, artist ১২টি। matplotlib নিজেই পরের default রং (কমলা) দিয়েছে।
- লেখা বসল।
set_titleআরset_xlabelনতুন artist বানায় না, আগে থেকে থাকা Text বস্তুর লেখা বদলায়; তাই artist সংখ্যা ১২-ই থাকল, কিন্তু শিরোনাম এখন 'Weekly orders'. - Legend তৈরি।
ax.legend()দুটি রেখার label পড়ে একটি Legend artist বানাল; সংখ্যা ১৩। label না দিলে legend খালি আসত আর matplotlib একটি সতর্কবার্তা দিত। পুরো ছবিটি এখন এক গাছের মতো: Figure → Axes → রেখা, Axis, লেখা, legend.
এই artist-এর গাছই matplotlib-এর শক্তি। যেকোনো জিনিস পরে ধরে বদলানো যায়: ax.lines[0].set_linewidth(3) প্রথম রেখা মোটা করে, ax.title.set_color("gray") শিরোনামের রং বদলায়। ছবি আঁকার মুহূর্তে matplotlib এই গাছ ঘুরে প্রতিটি artist-কে একটি backend-এর হাতে দেয়। PNG বানায় Agg নামের backend, SVG আর PDF-এর আলাদা লেখক আছে, আর ডেস্কটপে জানালায় দেখানোর জন্য GUI backend. পাতার ভেতরের Python Agg ব্যবহার করে, আর চালানো শেষে খোলা প্রতিটি figure-কে PNG বানিয়ে আউটপুটের নিচে দেখায়।
Jupyter-এ: notebook-এ cell-এর শেষে figure নিজে থেকেই cell-এর নিচে ছবি হয়ে আসে; পুরোনো টিউটোরিয়ালের %matplotlib inline magic আধুনিক JupyterLab-এ সাধারণত আর লিখতে হয় না, আর %matplotlib widget (ipympl প্যাকেজ লাগে) zoom করা যায় এমন chart দেয়। magic command কী, তা পর্ব ৮-এ আছে।
৩ · দুই রকম লেখার ধরন — pyplot-এর state বনাম object-oriented
matplotlib দুই রকমভাবে লেখা যায়, আর ইন্টারনেটের কোড দুটি মিশিয়ে ফেলে বলে নতুনরা প্রায়ই বিভ্রান্ত হন। প্রথমটি pyplot-এর ধরন: plt.plot(...), plt.title(...), plt.xlabel(...). এখানে আপনি কোনো বস্তুর নাম বলেন না; pyplot নিজে মনে রাখে কোনটি “বর্তমান” figure আর “বর্তমান” Axes, আর প্রতিটি ডাক সেখানেই যায়। একে বলে state machine, matplotlib-এর docs-এ implicit interface. দ্বিতীয়টি object-oriented API, docs-এ explicit interface: fig, ax = plt.subplots() দিয়ে বস্তু হাতে নিয়ে ax.plot, ax.set_title, ax.set_xlabel.
চায়ের দোকানে একজন কর্মচারী, মালিক চিৎকার করে বললেন “এক কাপ চিনি কম!” কোন টেবিলের জন্য? কর্মচারী ধরে নেন, যে টেবিলে তিনি শেষবার গিয়েছিলেন। দুটি টেবিল হলে এটি চলে; দশটি টেবিলে, মাঝে কেউ অন্য টেবিলে ডাকলে, ভুল কাপ ভুল টেবিলে যায়। pyplot-এর “বর্তমান Axes” ঠিক এই “শেষ যে টেবিলে গিয়েছিলেন”। Object-oriented ধরন মানে প্রতিবার টেবিলের নম্বর বলে দেওয়া: ax2.set_title, কোনো অনুমান নেই।
নিচে একই কাজ দুই ধরনে, পাশাপাশি। প্রতিটি ধাপে pyplot কী মনে রাখছে, তা লেখকের যন্ত্রে matplotlib 3.10.8-এ চালিয়ে মিলিয়ে দেখা।
# pyplot
plt.figure()
plt.subplot(1, 2, 1)
# বর্তমান = বাঁ Axes

# object-oriented
fig, (ax1, ax2) = plt.subplots(1, 2)
# pyplot
plt.plot([1, 2], [1, 2])
# যায় "বর্তমান" Axes-এ

# object-oriented
ax1.plot([1, 2], [1, 2])
# নাম ধরে ax1-এ
# pyplot
plt.subplot(1, 2, 2)
# বর্তমান বদলে ডান Axes

# object-oriented
# কিছু লাগে না:
# ax2 তো হাতেই আছে
# pyplot
plt.title("B")
# সত্যিকারের run:
title on a1: ''  a2: 'B'

# object-oriented
ax2.set_title("B")
ax1.set_title("A")
# যেকোনো ক্রমে
# pyplot
fig2, ax2b = plt.subplots()
# সত্যিকারের run:
fignums: [1, 2]
gca is ax2b: True
plt.close("all")
# fignums: []

# object-oriented
fig.savefig("first.png")
# fig এখনো হাতে
- শুরু। pyplot-এ
plt.subplot(1, 2, 1)একটি ১ সারি, ২ কলামের grid-এর প্রথম ঘর বানিয়ে সেটিকে “বর্তমান” করে। OO ধরনেplt.subplots(1, 2)একবারে দুটি ঘর বানিয়ে দুটিই আপনার হাতে দেয়। - আঁকা।
plt.plotনিজে জানে না কোথায় আঁকবে; সে pyplot-কে জিজ্ঞেস করে “বর্তমান Axes কোনটি?” (plt.gca(), get current axes) আর সেখানে আঁকে।ax1.plotকাউকে জিজ্ঞেস করে না। - ঘর বদল। pyplot-এ ডান ঘরে লিখতে হলে আগে “বর্তমান” বদলাতে হয়। এই লাইনটি ভুলে গেলে পরের সব কাজ চুপচাপ বাঁ ঘরে যাবে; কোনো error আসবে না।
- শিরোনাম।
plt.title("B")গেছে ডান ঘরে, কারণ শেষ বর্তমান ছিল সেটি; লেখকের run-এ বাঁ ঘরের শিরোনাম খালি ('') আর ডানটির'B'. OO ধরনে প্রতিটি ডাকের সামনে লক্ষ্য লেখা, তাই ক্রম যা-ই হোক ফল একই। - দুটি figure.
plt.subplots()আরেকটি figure খুলল; pyplot-এর খাতায় এখন দুটি figure ([1, 2]) আর “বর্তমান” নতুনটি। এরপরplt.titleলিখলে তা যাবে নতুন figure-এ। OO ধরনে পুরোনোfigভ্যারিয়েবলে ধরা আছে, তাই পরেও সেটিই সংরক্ষণ করা যায়।plt.close("all")সব figure বন্ধ করে মেমরি ছাড়ে।
এই কোর্স কেন object-oriented ধরন ব্যবহার করে? তিনটি কারণে। এক, একাধিক Axes হলে কোন কাজ কোথায় যাচ্ছে তা কোড পড়েই বোঝা যায়। দুই, chart আঁকার ফাংশন লেখা সহজ হয়: def plot_sales(ax, data): যেকোনো Axes নিতে পারে, যেকোনো figure-এর যেকোনো ঘরে আঁকতে পারে, আর test করা যায় (পর্ব ১১)। তিন, matplotlib-এর নিজের docs জটিল chart-এর জন্য explicit interface সুপারিশ করে, আর pandas ও seaborn-এর ফাংশনও ax= নেয়। তবে pyplot একেবারে বাদ নয়: plt.subplots(), plt.show(), plt.close() আর plt.style.use() pyplot থেকেই আসে, আর notebook-এ এক লাইনের দ্রুত chart-এ plt.plot(x, y) পুরোপুরি ঠিক। নিয়ম হলো, একই chart-এ দুটি মেশাবেন না।
নামের ছোট ফাঁদ: pyplot-এ plt.title("..."), plt.xlabel, plt.xlim; Axes-এ সেগুলো ax.set_title, ax.set_xlabel, ax.set_xlim. মিশিয়ে লিখলে সত্যিকারের run-এ (matplotlib 3.11.2) যা আসে: ax.title("Sales") দিলে TypeError: 'Text' object is not callable, কারণ ax.title একটি Text বস্তু, ফাংশন নয়; আর plt.set_title("Sales") দিলে AttributeError: module 'matplotlib.pyplot' has no attribute 'set_title'.
৪ · ধাপে ধাপে একটি bar chart — label, টাকার tick আর annotation
এবার বাজারঘরের আসল প্রশ্ন: কোন জেলায় বিক্রি কত? ৬০০টি কাল্পনিক অর্ডার seed দিয়ে বানানো, তাই প্রত্যেক পাঠক একই সংখ্যা পাবেন। দাম পয়সায় পূর্ণসংখ্যা হিসেবে রাখা (পর্ব ২০-এর নিয়ম), chart-এ দেখানো হবে টাকায়। দলভিত্তিক তুলনার স্বাভাবিক ছবি bar chart. কোডের মন্তব্যে পাঁচটি ধাপ নম্বর দেওয়া: ফাঁকা Axes, ডেটা, লেখা, tick, আর রেখা ও তীর।
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.ticker import StrMethodFormatter

rng = np.random.default_rng(42)          # বাজারঘর: ৬০০টি কাল্পনিক অর্ডার
n = 600
districts = ["Dhaka", "Chattogram", "Khulna", "Rajshahi", "Sylhet"]
orders = pd.DataFrame({
    "district": rng.choice(districts, size=n, p=[0.38, 0.24, 0.14, 0.13, 0.11]),
    "qty": rng.integers(1, 4, size=n),
    "price_paisa": rng.integers(150, 2500, size=n) * 100,
})
orders["total_paisa"] = orders["qty"] * orders["price_paisa"]
sales_tk = (orders.groupby("district")["total_paisa"].sum() // 100
            ).sort_values(ascending=False)
print(sales_tk)

fig, ax = plt.subplots(figsize=(6, 3.5), layout="constrained")   # ১) ফাঁকা Axes
bars = ax.bar(sales_tk.index, sales_tk.to_numpy(), color="tab:blue")  # ২) ডেটা
ax.set_title("Bazarghar sales by district (simulated)")          # ৩) লেখা
ax.set_ylabel("Sales (taka)")
ax.yaxis.set_major_formatter(StrMethodFormatter("Tk {x:,.0f}"))  # ৪) tick
ax.set_ylim(0, sales_tk.max() * 1.18)
avg = sales_tk.mean()                                            # ৫) রেখা আর তীর
ax.axhline(avg, color="gray", ls="--", lw=1)
ax.text(4.45, avg * 1.04, f"mean Tk {avg:,.0f}", ha="right", fontsize=9)
ax.annotate("largest market", xy=(0, sales_tk.iloc[0]),
            xytext=(1.0, sales_tk.iloc[0] * 1.08),
            arrowprops=dict(arrowstyle="->"))
print("bars:", len(bars), "| y-limits:", [round(v) for v in ax.get_ylim()])
fmt = ax.yaxis.get_major_formatter()     # tick-এর সংখ্যা → লেখা
print("tick labels:", [fmt(t) for t in ax.get_yticks()[:3]])
plt.show()
ব্রাউজারে আসল আউটপুট, নিচে ছবিসহ:
district
Dhaka         597588
Chattogram    367852
Rajshahi      227157
Khulna        208412
Sylhet        169344
Name: total_paisa, dtype: int64
bars: 5 | y-limits: [0, 705154]
tick labels: ['Tk 0', 'Tk 100,000', 'Tk 200,000']
ঢাকার বিক্রি ৫,৯৭,৫৮৮ টাকা, সবচেয়ে কম সিলেটে ১,৬৯,৩৪৪ টাকা। sort_values করা হয়েছে বলে bar বড় থেকে ছোটয় সাজানো; তুলনার chart-এ এটি পড়া অনেক সহজ করে। ধাপগুলো মিলিয়ে নিন। ax.bar পাঁচটি Rectangle artist ফেরত দিয়েছে (bars: 5). set_ylim(0, max × 1.18) ওপরের সীমা ৫,৯৭,৫৮৮ × ১.১৮ ≈ ৭,০৫,১৫৪ করেছে, যাতে তীর আর লেখার জায়গা থাকে; নিচের সীমা ০, কারণ bar-এর দৈর্ঘ্যই মান বোঝায়, ০ থেকে শুরু না হলে চোখ ঠকে (এ নিয়ে বিস্তারিত পর্ব ৩২-এ)। tick formatter StrMethodFormatter("Tk {x:,.0f}") প্রতিটি tick-এর সংখ্যা x-কে Python-এর format নিয়মে লেখে: , মানে হাজারের কমা, .0f মানে দশমিক নেই। শেষ লাইনে formatter-কে সরাসরি ডেকে প্রথম তিনটি tick-এর সংখ্যা (ax.get_yticks()) লেখায় রূপ দেওয়া হয়েছে; ছবিতে ঠিক এই লেখাই বসে। axhline গোটা প্রস্থজুড়ে গড়ের (৩,১৪,০৭১) একটি অনুভূমিক রেখা টেনেছে, আর annotation ax.annotate একটি বিন্দু (xy, ঢাকার bar-এর মাথা) আর লেখার জায়গা (xytext) নিয়ে মাঝখানে তীর আঁকে। bar chart-এ x-অক্ষের প্রথম দলের অবস্থান ০, দ্বিতীয়টির ১, এভাবে; তাই xy=(0, ...).
কয়েকটি ব্যবহারিক বিষয়। টাকার চিহ্ন ৳ (Unicode U+09F3) বাংলা লিপির ব্লকে, আর matplotlib-এর default ফন্ট DejaVu Sans-এ সেটি নেই; তাই ছবিতে “Tk” লেখা নিরাপদ, নইলে একটি খালি বাক্স আর সতর্কবার্তা আসবে। Python-এর , আন্তর্জাতিক নিয়মে তিন অঙ্ক পরপর কমা দেয় (100,000); বাংলাদেশের লাখ-কোটির নিয়মে (১,০০,০০০) দেখাতে চাইলে নিজের ফাংশন লিখে FuncFormatter-এ দিতে হয়, যা অনুশীলনের প্রথম কাজ। জেলার নাম লম্বা হলে বা দল অনেক হলে আড়াআড়ি bar, ax.barh, পড়তে সহজ, কারণ লেখা তখন কাত করতে হয় না। আর tick কোথায় বসবে তা নিজে ঠিক করতে ax.set_yticks([0, 200_000, 400_000, 600_000]); matplotlib-এর default AutoLocator সাধারণত “সুন্দর” গোল সংখ্যা নিজেই বাছে।
৫ · line, scatter, histogram আর কয়েকটি Axes একসঙ্গে
চারটি মূল chart-এর প্রতিটি একটি আলাদা প্রশ্নের উত্তর দেয়। Line plot (ax.plot) ক্রম আছে এমন ডেটার বদল দেখায়, যেমন দিনের পর দিন অর্ডার। Scatter plot (ax.scatter) প্রতিটি পর্যবেক্ষণকে আলাদা বিন্দু করে, যেমন Anscombe-এর ছবি। Histogram (ax.hist) একটি সংখ্যার কলামকে কয়েকটি ব্যবধানে (bin) ভাগ করে প্রতিটিতে কতগুলো মান পড়ল তা দেখায়, মানে ডেটার বণ্টন। কোন প্রশ্নে কোন chart, সেটি পরের পর্বের পুরো বিষয়; এখানে আঁকার যন্ত্রপাতি।
নিচের কোডে একটি Figure-এ পাশাপাশি দুটি Axes, subplot. বাঁয়ে নভেম্বরের ৩০ দিনের অর্ডার বিন্দু হিসেবে, আর একই Axes-এ ৭ দিনের চলমান গড় রেখা হিসেবে (rolling, পর্ব ২৬), দুটির জন্য একটি legend. ডানে ৫০০টি অর্ডারের ডেলিভারির দিনের histogram.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
day = np.arange(1, 31)                                   # নভেম্বরের ৩০ দিন
orders = 40 + 0.6 * day + rng.normal(0, 5, size=30)      # প্রতিদিনের অর্ডার
week_mean = pd.Series(orders).rolling(7).mean()          # ৭ দিনের চলমান গড়
delivery = rng.choice(np.arange(1, 8), size=500,
                      p=[0.10, 0.28, 0.27, 0.16, 0.10, 0.06, 0.03])

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(7, 3.2), layout="constrained")
ax1.scatter(day, orders, s=14, color="tab:blue", label="daily orders")
ax1.plot(day, week_mean, color="tab:orange", lw=2, label="7-day mean")
ax1.set(xlabel="Day of month", ylabel="Orders", title="Orders per day")
ax1.set_xlim(0, 31)
ax1.legend(loc="upper left", fontsize=8)

counts, edges, _ = ax2.hist(delivery, bins=np.arange(0.5, 8.5, 1),
                            color="tab:green", edgecolor="white")
ax2.set(xlabel="Delivery days", ylabel="Orders", title="Delivery time")
ax2.set_xticks(range(1, 8))

print("first 7-day mean (day 7):", round(week_mean.iloc[6], 1))
print("last  7-day mean (day 30):", round(week_mean.iloc[-1], 1))
print("bin edges:", edges)
print("counts   :", counts.astype(int), "sum =", int(counts.sum()))
print("lines:", len(ax1.lines), "| collections:", len(ax1.collections),
      "| bars:", len(ax2.patches))
plt.show()
ব্রাউজারে আসল আউটপুট, নিচে ছবিসহ:
first 7-day mean (day 7): 40.9
last  7-day mean (day 30): 56.8
bin edges: [0.5 1.5 2.5 3.5 4.5 5.5 6.5 7.5]
counts   : [ 45 150 132  88  43  33   9] sum = 500
lines: 1 | collections: 1 | bars: 7
চলমান গড় শুরু হয়েছে ৭ নম্বর দিন থেকে, কারণ প্রথম ছয় দিনে সাতটি মান নেই (সেগুলো NaN, তাই রেখা সেখানে আঁকা হয়নি); গড় ৪০.৯ থেকে বেড়ে ৫৬.৮, মানে মাসজুড়ে অর্ডার বেড়েছে, যদিও দৈনিক বিন্দুগুলো বেশ লাফায়। এখানে দুই রকম artist: রেখা ax1.lines-এ (১টি), আর scatter-এর বিন্দুগুলো একসঙ্গে একটি PathCollection, তাই collections: 1. Legend দুটির label পড়ে দুটি এন্ট্রি বানিয়েছে। Histogram-এ bin-এর কিনারা ইচ্ছা করে ০.৫, ১.৫, … ৭.৫ রাখা, যাতে প্রতিটি পূর্ণসংখ্যার দিন একটি bar-এর ঠিক মাঝখানে পড়ে; শুধু bins=7 দিলে matplotlib ১ থেকে ৭-এর পরিসর সমান সাত ভাগে কাটত আর কিনারা পূর্ণসংখ্যার ওপর পড়ত। ax.hist তিনটি জিনিস ফেরত দেয়: প্রতিটি bin-এর গণনা, কিনারাগুলো আর bar-এর artist; গণনার যোগফল ৫০০, মানে কোনো অর্ডার বাদ পড়েনি। সবচেয়ে বেশি অর্ডার ২ দিনে (১৫০টি), আর ৭ দিন লেগেছে মাত্র ৯টিতে। ax.set(...) একসঙ্গে কয়েকটি set_* ডাকার সংক্ষিপ্ত রূপ।
কয়েকটি Axes সাজানো — subplots, figsize আর constrained layout
plt.subplots(nrows, ncols) একটি Figure আর Axes-এর grid একসঙ্গে দেয়। ফেরত আসা জিনিসের আকার মনে রাখুন: ১ × ১ হলে একটি Axes বস্তু, ১ × n বা n × ১ হলে এক মাত্রার array, আর ২ × ৩ হলে (2, 3) আকারের array, যার একটি ঘর axes[1, 0]. সব সময় array চাইলে squeeze=False. sharex=True বা sharey=True অক্ষের পরিসর বেঁধে দেয়, যাতে ঘরে ঘরে তুলনা সৎ হয়; sharex="col" শুধু একই কলামের ঘরগুলো বাঁধে। figsize=(প্রস্থ, উচ্চতা) ইঞ্চিতে; ফোনে পড়ার ছবির জন্য এই পাতায় (৬, ৩.৫)-এর কাছাকাছি রাখা হয়েছে। আর layout="constrained" চালু করে constrained layout, যা শিরোনাম, লেবেল আর legend-এর মাপ হিসাব করে ঘরগুলোর মাঝে জায়গা রাখে, যাতে এক ঘরের লেখা পাশের ঘরে না ঢোকে। পুরোনো কোডে একই কাজে plt.tight_layout() দেখবেন; constrained layout বেশি ক্ষেত্রে ভালো কাজ করে, বিশেষ করে fig.suptitle, fig.supxlabel আর colorbar থাকলে।
৬ · pandas থেকে সরাসরি chart — df.plot আর তার সীমা
pandas-এর প্রতিটি Series আর DataFrame-এর একটি .plot method আছে, যা ভেতরে matplotlib ডাকে আর একটি Axes ফেরত দেয়। তাই দ্রুত একটি chart বানিয়ে তারপর আগের সব object-oriented কৌশলে সাজানো যায়। নিয়মটি সহজ: DataFrame-এর index যায় x-অক্ষে, প্রতিটি কলাম হয় একটি রেখা বা একরঙা bar-এর সারি, আর কলামের নাম legend-এ। Groupby-এর পর unstack (পর্ব ২৫) দিয়ে ঠিক এই আকার পাওয়া যায়: সারি = মাস, কলাম = জেলা।
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.ticker import StrMethodFormatter

rng = np.random.default_rng(42)          # বাজারঘর: আগস্ট–অক্টোবরের ৯০০টি অর্ডার
n = 900
orders = pd.DataFrame({
    "date": pd.Timestamp("2026-08-01")
            + pd.to_timedelta(rng.integers(0, 92, size=n), unit="D"),
    "district": rng.choice(["Dhaka", "Chattogram", "Khulna"], size=n,
                           p=[0.5, 0.3, 0.2]),
    "price_paisa": rng.integers(150, 2500, size=n) * 100,
})
monthly = (orders.groupby([orders["date"].dt.month, "district"])["price_paisa"]
           .sum().div(100).unstack())             # সারি = মাস, কলাম = জেলা
monthly.index = ["Aug", "Sep", "Oct"]
print(monthly.astype(int))

ax = monthly.plot(kind="bar", figsize=(6, 3.5), rot=0, width=0.75)
print("df.plot returned:", type(ax).__name__)
ax.set_title("Monthly sales by district (simulated)")
ax.set_xlabel("")
ax.set_ylabel("Sales (taka)")
ax.yaxis.set_major_formatter(StrMethodFormatter("Tk {x:,.0f}"))
ax.legend(title="District", ncols=3, fontsize=8, loc="upper center")
ax.set_ylim(0, monthly.to_numpy().max() * 1.25)
ax.figure.set_layout_engine("constrained")
print("bars:", len(ax.patches), "| legend:", [t.get_text() for t in ax.get_legend().get_texts()])
plt.show()
ব্রাউজারে আসল আউটপুট, নিচে ছবিসহ:
district  Chattogram   Dhaka  Khulna
Aug           124143  200503   79050
Sep           106423  204578   71127
Oct           112967  203499   93410
df.plot returned: Axes
bars: 9 | legend: ['Chattogram', 'Dhaka', 'Khulna']
এক লাইনের monthly.plot(kind="bar") তিন মাস × তিন জেলা = ৯টি bar এঁকেছে, x-অক্ষে index (Aug, Sep, Oct), legend-এ কলামের নাম। ফেরত এসেছে একটি সাধারণ Axes, তাই শিরোনাম, টাকার formatter, legend-এর জায়গা, ylim সবই আগের মতো বসানো গেল; Figure-টি পাওয়া যায় ax.figure দিয়ে। rot=0 x-এর লেখা সোজা রাখে (pandas-এর bar chart default-এ ৯০ ডিগ্রি ঘুরিয়ে দেয়)। একটি জিনিস খেয়াল করুন: কলামের ক্রম Chattogram, Dhaka, Khulna, মানে বর্ণানুক্রমিক, কারণ groupby key সাজিয়ে দেয় (পর্ব ২৪)। ঢাকাকে আগে দেখাতে চাইলে plot-এর আগে কলাম নিজে সাজাতে হবে, যেমন monthly[["Dhaka", "Chattogram", "Khulna"]]. ঢাকার বিক্রি তিন মাসেই প্রায় ২ লাখ টাকা, খুলনা অক্টোবরে বেড়েছে; এটি simulated ডেটা, তাই কোনো সত্যিকারের প্রবণতা ধরে নেবেন না।
df.plot কখন যথেষ্ট, কখন নয়। দ্রুত দেখার জন্য এটি দারুণ: s.plot.hist(bins=20), df.plot.scatter(x="qty", y="rating"), df.plot(subplots=True). কিন্তু সীমাও আছে। এক, নিয়ন্ত্রণ আংশিক: pandas কিছু সিদ্ধান্ত নিজে নেয় (রং, লেখা ঘোরানো, সময়ের index-এ নিজস্ব tick), যা পরে বদলাতে হয়। দুই, “লম্বা” বা tidy ডেটা থেকে রং অনুযায়ী ভাগ করতে আগে pivot বা unstack করতে হয়; seaborn সেখানে hue="district" দিয়েই কাজ সারে (পর্ব ৩০)। তিন, পরিসংখ্যানের ছবি, যেমন দলভিত্তিক বণ্টন বা আত্মবিশ্বাসের ব্যবধান, এখানে নেই। নিয়ন্ত্রণ নিজের হাতে রাখার ভালো অভ্যাস: আগে fig, ax = plt.subplots(), তারপর df.plot(ax=ax); এতে pandas আপনার বানানো Axes-এ আঁকে।
৭ · চেহারা বদলানো — style আর rcParams
প্রতিটি chart-এ ফন্টের আকার, grid, রঙের তালিকা আলাদা করে বসানো ক্লান্তিকর। matplotlib-এর সব default থাকে একটি বড় dict-এর মতো জায়গায়, rcParams (নামটি এসেছে Unix-এর “rc” সেটিং ফাইলের রীতি থেকে)। লেখকের যন্ত্রে matplotlib 3.11.2-এ default ছিল figure.figsize = [6.4, 4.8] ইঞ্চি আর figure.dpi = 100. বদলানোর তিনটি স্তর:
import matplotlib.pyplot as plt

plt.rcParams["axes.grid"] = True            # ১) এই প্রক্রিয়ার বাকি সব chart-এ
plt.rcParams.update({"font.size": 11, "axes.spines.top": False})

with plt.rc_context({"lines.linewidth": 3}):  # ২) শুধু এই ব্লকের ভেতরে
    fig, ax = plt.subplots()
    ax.plot([1, 2, 3], [3, 1, 2])

plt.style.use("tableau-colorblind10")       # ৩) তৈরি style: অনেক সেটিং একসঙ্গে
print(plt.style.available[:4])
Style sheet হলো অনেকগুলো rcParams-এর তৈরি প্যাকেট। লেখকের যন্ত্রে matplotlib 3.11.2-এ plt.style.available-এ ২৮টি style ছিল, যেমন 'ggplot', 'bmh', 'fivethirtyeight', 'grayscale', 'dark_background', 'tableau-colorblind10', 'petroff10' আর 'seaborn-v0_8-whitegrid'-এর মতো বেশ কয়েকটি seaborn-নামের style. শেষেরগুলোর নামে v0_8 আছে কারণ matplotlib 3.6-এ পুরোনো 'seaborn' নামগুলো বাতিলের ঘোষণা দিয়ে নতুন নাম দেওয়া হয়, আর পরে (3.8-এ) পুরোনোগুলো সরানো হয়; AI বা পুরোনো ব্লগের plt.style.use("seaborn") এখন চালালে সত্যিকারের run-এ OSError: 'seaborn' is not a valid package style, … আসে। রঙের ক্ষেত্রে এই কোর্সের নিয়ম: default tab10 বা tableau-colorblind10-এর মতো বর্ণান্ধ-বান্ধব তালিকা, আর ক্রমানুসারী মানের জন্য viridis বা cividis; শুধু লাল বনাম সবুজ দিয়ে কোনো পার্থক্য বোঝাবেন না। রং আর পাঠযোগ্যতা নিয়ে পুরো আলোচনা পর্ব ৩২-এ।
পাতার Python আর rcParams: এই পাতায় প্রতিটি কোড ব্লক চালানোর পর matplotlib-এর সেটিং default-এ ফিরিয়ে দেওয়া হয়, তাই এক ব্লকের style পরের ব্লকে ছড়ায় না। নিজের notebook-এ তা হয় না: একটি cell-এ plt.style.use বা rcParams বদলালে kernel চালু থাকা পর্যন্ত পরের সব chart বদলে যায়। ফেরাতে plt.rcdefaults(), আর একটি chart-এর জন্য শুধু হলে plt.rc_context নিরাপদ।
৮ · ছবি সংরক্ষণ — savefig, dpi, PNG, SVG আর PDF
Chart বানানোর শেষ ধাপ প্রায়ই একটি ফাইল: রিপোর্টে বসানো, ওয়েবসাইটে দেওয়া, ছাপানো। দুই রকম ছবির পার্থক্য আগে বুঝে নিন। Raster ছবি (PNG, JPEG) হলো pixel-এর grid, ঠিক পর্ব ১৮-এর array; বড় করলে খাঁজ দেখা যায়। Vector ছবি (SVG, PDF) হলো রেখা আর আকারের বর্ণনা, “এখান থেকে ওখানে একটি রেখা”; যত বড়ই করুন, ধার তীক্ষ্ণ থাকে। মুদি দোকানের তুলনা দিই: raster হলো তৈরি রুটি, যত বড় পাত্রেই রাখুন রুটি একই; vector হলো রেসিপি, যেকোনো আকারে নতুন করে বানানো যায়।
Raster ছবির pixel সংখ্যা ঠিক করে dpi (dots per inch): pixel = figsize (ইঞ্চি) × dpi. ৬ × ৩.৫ ইঞ্চির figure, dpi 100-এ ৬০০ × ৩৫০ pixel; dpi 200-এ ১২০০ × ৭০০, মানে চারগুণ pixel. নিচের ধাপে একটি savefig ডাকের প্রতিটি অংশ, সংখ্যাগুলো লেখকের যন্ত্রের সত্যিকারের run থেকে:
fig.savefig(— Figure বস্তুর method; যে figure আপনার হাতে, সেটিই সংরক্ষণ হবে।plt.savefig-ও আছে, কিন্তু সেটি “বর্তমান” figure সংরক্ষণ করে, অংশ ৩-এর সেই অনুমানের ফাঁদ।"delivery.png"— ফাইলের নামের শেষাংশ (extension) দেখেই matplotlib format বাছে:.png,.svg,.pdf,.jpg. লেখকের run-এ একই histogram: PNG ১৩,০০৬ বাইট, SVG ২৫,২৬৪ বাইট, PDF ১১,৬২২ বাইট।dpi=200— শুধু raster-এর জন্য অর্থবহ। ৬ × ৩.৫ ইঞ্চি × 200 = ১২০০ × ৭০০ pixel, ফাইল ১৩,০০৬ থেকে বেড়ে ২৯,৩৪৪ বাইট। না দিলেsavefig.dpi-এর default'figure', মানে figure-এর নিজের dpi (100).bbox_inches="tight"— লেখা আর অক্ষ যতটুকু জায়গা নেয়, তার চারপাশে ০.১ ইঞ্চি রেখে বাকি সাদা কিনারা কেটে দেয়। লেখকের run-এ dpi 100-এ ৬০০ × ৩৫০ থেকে হলো ৫৩২ × ৩৫৪: প্রস্থে ফাঁকা কিনারা কাটা পড়েছে, আর উচ্চতা সামান্য বেড়েছে কারণ শিরোনাম figure-এর কিনারা ঘেঁষে ছিল। মানে ছবির আকার আর ঠিক figsize × dpi থাকে না।facecolor="white"— পেছনের রং। Dark style বাtransparent=True-এর সঙ্গে ঝামেলা এড়াতে স্পষ্ট করে দেওয়া ভালো, কারণ স্বচ্ছ PNG রাতের-থিমের পাতায় কালো লেখাকে প্রায় অদৃশ্য করে দেয়।
পাতার ভেতরের Python-এ নিজের কোড থেকে savefig ডাকলে Pyodide-এর matplotlib একটি deprecation সতর্কবার্তা ছাপে, তাই এই অংশ লেখকের যন্ত্রের run দিয়ে দেখানো। সংখ্যাগুলোর উৎস, লেখকের যন্ত্রে Python 3.14.4 আর matplotlib 3.11.2 দিয়ে (লেখার সময়ের সংস্করণ) একটি ছোট script, যা ৪০০টি seed করা ডেলিভারি-দিনের histogram আঁকে আর পাঁচভাবে সংরক্ষণ করে প্রতিটি ফাইলের আকার ছাপে। সত্যিকারের run, ফোল্ডারের পথ নিরপেক্ষ করা:
~/bazarghar-ai/charts$ python save_formats.py
Python 3.14.4 | matplotlib 3.11.2
default figsize: [6.4, 4.8] dpi: 100.0
savefig.dpi: figure
styles: 28
chart_100.png     13,006 bytes  600x350 px
chart_200.png     29,344 bytes  1200x700 px
chart_tight.png   12,962 bytes  532x354 px
chart.svg         25,264 bytes
chart.pdf 11,622 bytes| Format | ধরন | কখন | সাবধান |
|---|---|---|---|
| PNG | raster, ক্ষতিহীন সংকোচন | ওয়েব, স্লাইড, chat-এ শেয়ার | dpi ঠিক করুন; ছাপায় ১৫০–৩০০ |
| SVG | vector, XML লেখা | ওয়েবপাতা, পরে Inkscape-এ সম্পাদনা | লাখো বিন্দুর scatter-এ ফাইল বিশাল |
| vector, ফন্ট ভেতরে | ছাপা, গবেষণাপত্র, LaTeX | ব্রাউজারে সরাসরি <img> হিসেবে চলে না | |
| JPEG | raster, ক্ষতিকর সংকোচন | ফটোগ্রাফ; chart-এর জন্য নয় | লেখা আর রেখার কিনারায় ঝাপসা দাগ |
একটি মাঝামাঝি কৌশল: খুব বেশি বিন্দুর scatter-এ ax.scatter(..., rasterized=True) দিলে শুধু বিন্দুগুলো pixel হিসেবে ঢোকে, অক্ষ আর লেখা vector থাকে; ফলে PDF ছোট থাকে অথচ লেখা তীক্ষ্ণ। আর script-এ একটি পুরোনো ফাঁদ: GUI backend-এ plt.show()-এর জানালা বন্ধ করলে figure-ও বন্ধ হয়ে যায়, তাই তারপর plt.savefig একটি ফাঁকা ছবি লেখে। নিয়ম: আগে fig.savefig, তারপর show; লুপে অনেক chart বানালে প্রতিটির পরে plt.close(fig), নইলে মেমরি বাড়তেই থাকে আর matplotlib ২০টির বেশি খোলা figure-এ সতর্কবার্তা দেয়।
৯ · figure-এ বাংলা লেখা — কেন ভাঙে, এখন কী অবস্থা
এই কোর্সের পাঠকদের জন্য সবচেয়ে বাস্তব প্রশ্ন: chart-এর শিরোনামে “জেলাভিত্তিক বিক্রি” লেখা যায় কি? উত্তর matplotlib-এর সংস্করণের ওপর নির্ভর করে, আর ২০২৬ সালে উত্তরটি বদলেছে। আগে বুঝে নিন সমস্যাটি কোথায়।
কম্পিউটারে বাংলা লেখা থাকে উচ্চারণের ক্রমে, দেখার ক্রমে নয়। “কি” শব্দটি Unicode-এ দুটি code point: আগে ক, তারপর ি-কার; অথচ ছাপায় ি বসে ক-এর বাঁয়ে। “ক্র” হলো ক + ্ (হসন্ত) + র, কিন্তু দেখায় একটি মিলিত রূপ, র-ফলা। “ত্ত” দুটি ত আর একটি হসন্ত, দেখায় একটি যুক্তাক্ষর। Code point-এর এই সারিকে ফন্টের সঠিক glyph-এ, সঠিক ক্রমে আর সঠিক জায়গায় বসানোর কাজকে বলে text shaping. এর নিয়ম থাকে ফন্টের ভেতরের OpenType টেবিলে, আর সেগুলো প্রয়োগ করে একটি shaping engine, সবচেয়ে প্রচলিতটি খোলা উৎসের HarfBuzz, যা আধুনিক ব্রাউজার আর অনেক অপারেটিং সিস্টেমের ভেতরে আছে। Unicode আর grapheme cluster-এর ধারণা আপনি পর্ব ৯-এ দেখেছেন।
matplotlib 3.10 পর্যন্ত Agg backend এই shaping করত না: প্রতিটি code point-এর জন্য ফন্ট থেকে একটি glyph নিয়ে বাঁ থেকে ডানে পাশাপাশি বসাত, শুধু kerning (অক্ষরের মাঝের ফাঁক) ঠিক করে। ইংরেজির জন্য এটি যথেষ্ট, বাংলার জন্য নয়। আর দুটি আলাদা সমস্যা প্রায়ই এক সঙ্গে আসে। প্রথমটি ফন্টের: default DejaVu Sans-এ বাংলা অক্ষরই নেই। লেখকের যন্ত্রে শুধু ax.set_title("ঢাকা") দিয়ে সংরক্ষণ করলে সত্যিকারের run-এ এই সতর্কবার্তাগুলো এসেছে (সংক্ষেপিত):
matplotlib 3.10.8:
UserWarning: Glyph 2466 (\N{BENGALI LETTER DDHA}) missing from font(s) DejaVu Sans.
UserWarning: Matplotlib currently does not support Bengali natively.
UserWarning: Glyph 2453 (\N{BENGALI LETTER KA}) missing from font(s) DejaVu Sans.
…
matplotlib 3.11.2:
UserWarning: Glyph 2466 (\N{BENGALI LETTER DDHA}) missing from font(s) DejaVu Sans.
UserWarning: Glyph 2453 (\N{BENGALI LETTER KA}) missing from font(s) DejaVu Sans.
ছবিতে তখন বাক্স বা চিহ্ন আসে। দ্বিতীয় সমস্যাটি আরও সূক্ষ্ম: বাংলা ফন্ট দিলে সতর্কবার্তা চলে যায়, কিন্তু লেখা তবু ভুল। লেখক Google-এর খোলা লাইসেন্সের Noto Sans Bengali ফন্ট নামিয়ে font_manager.fontManager.addfont দিয়ে যোগ করে, font.family-তে ["Noto Sans Bengali", "DejaVu Sans"] দিয়ে (ইংরেজি অক্ষরের জন্য font fallback) একই ছোট chart দুই সংস্করণে এঁকেছেন:
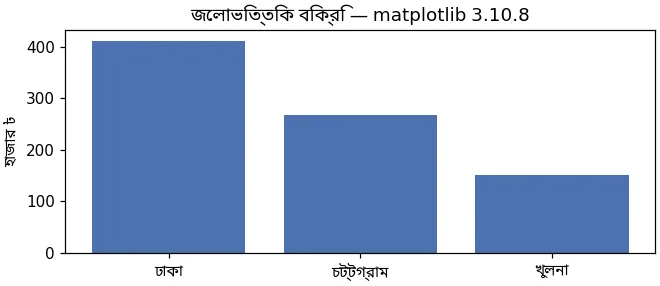
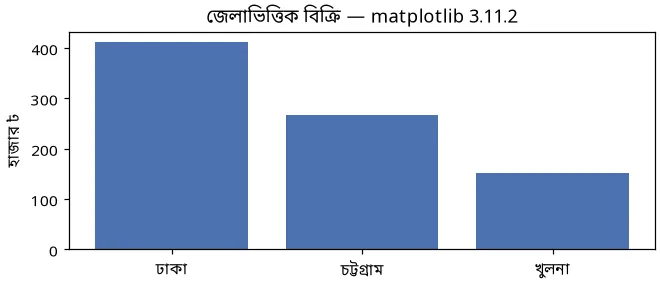
কী বদলাল? matplotlib 3.11.0 প্রকাশিত হয় ১২ জুন ২০২৬। প্রকল্পের ঘোষণা অনুযায়ী এই সংস্করণে লেখা আর ফন্টের পুরো প্রক্রিয়া নতুন করে লেখা হয়েছে, libraqm, HarfBuzz, SheenBidi আর FreeType-এর নতুন সংস্করণ দিয়ে; release notes-এর “Complex text layout with libraqm” অংশে আরবি-হিব্রুর মতো ভাষা, ligature আর diacritic-এর কথা আছে, সঙ্গে সতর্কতা যে সব সুবিধা ফন্টের সমর্থনের ওপর নির্ভর করে আর DejaVu Sans-এর বাইরে আলাদা ফন্ট লাগতে পারে। ঘোষণায় এ-ও বলা আছে যে এই লাইব্রেরিগুলোর সব সুবিধা এখনো যুক্ত হয়নি। Release notes-এ বাংলার নাম আলাদা করে নেই, তাই লেখক নিজে যাচাই করেছেন: Agg-এর PNG (ছবি ২৮.৩) আর default SVG (যেখানে লেখা path হিসেবে ঢোকে) দুটিতেই 3.11.2-এ বাংলা ঠিক এসেছে, 3.10.8-এ দুটিতেই ভাঙা। PDF লেখক নিজে যাচাই করেননি। 3.11-এ কোনো ফন্টে অক্ষর না পেলে বাক্সের বদলে Unicode Consortium-এর “Last Resort” ফন্টের একটি চিহ্ন আসে, যা বলে দেয় কোন লিপির অক্ষর হারিয়েছে। পুরোনো পথ mplcairo (Raqm সহ) এই সুবিধা আগে থেকেই দিত, আর তার README-ও এখন বলে matplotlib 3.11-এ এটি এসেছে।
# matplotlib >= 3.11 এবং একটি বাংলা ফন্ট (যেমন Noto Sans Bengali) লাগবে
import matplotlib.pyplot as plt
from matplotlib import font_manager

font_manager.fontManager.addfont("fonts/NotoSansBengali-Regular.ttf")
plt.rcParams["font.family"] = ["Noto Sans Bengali", "DejaVu Sans"]

fig, ax = plt.subplots(figsize=(6, 2.6), layout="constrained")
ax.bar(["ঢাকা", "চট্টগ্রাম", "খুলনা"], [412, 268, 151])
ax.set_title("জেলাভিত্তিক বিক্রি")
ax.set_ylabel("হাজার ৳")
fig.savefig("bangla_chart.png", dpi=110)
এই পাতার Python এখনো 3.10.8. ব্রাউজারের Pyodide-এ matplotlib 3.10.8, কোনো বাংলা ফন্টও নেই; তাই এই পাতার প্রতিটি chart-এর লেখা ইংরেজিতে, আর ব্যাখ্যা বাংলায় আশপাশের লেখায়। বাংলা লেবেল দিলে পাতা একটি নোট দেখায়। Colab, পুরোনো সার্ভার বা অফিসের যন্ত্রেও প্রায়ই পুরোনো matplotlib থাকে; নিজের প্রকল্পে import matplotlib; print(matplotlib.__version__) দিয়ে দেখে নিন, আর lockfile-এ সংস্করণ বেঁধে রাখুন (পর্ব ১২)।
কাজের পরামর্শ
- সবচেয়ে নিরাপদ: ছবির ভেতরের লেখা ইংরেজিতে (Dhaka, Chattogram, Khulna, Rajshahi, Sylhet), আর বাংলা শিরোনাম, ব্যাখ্যা ও সূত্র ছবির নিচের caption-এ বা HTML-এ। এটি সব সংস্করণে চলে, সার্চ ইঞ্জিন পড়তে পারে, আর screen reader HTML লেখা পড়ে শোনাতে পারে, ছবির ভেতরের লেখা পারে না।
- ছবিতেই বাংলা লাগলে: matplotlib 3.11 বা পরের সংস্করণ, একটি বাংলা ফন্ট যোগ করা, ইংরেজির জন্য fallback তালিকা; তারপর প্রকাশের মাপে ছবিটি চোখে দেখে যাচাই, বিশেষ করে ি, ে, ৈ, ো আর র-ফলা, য-ফলা, ক্ষ, ত্ত.
- পুরোনো matplotlib-এ আটকে থাকলে:
plt.rcParams["svg.fonttype"] = "none"দিয়ে SVG সংরক্ষণ করলে লেখা SVG-র ভেতরে সাধারণ লেখা হিসেবে থাকে আর ব্রাউজার নিজে shaping করে। লেখকের run-এ 3.10.8 দিয়ে এভাবে বানানো SVG Edge-এ সঠিক বাংলা দেখিয়েছে। সীমা: দেখার যন্ত্রে একটি বাংলা ফন্ট থাকতে হবে, আর matplotlib লেখার প্রস্থ ভুল মাপে, তাই লেখা একটু সরে যেতে পারে। - অন্য পথ: লেখা ছবির বাইরে আঁকা, যেমন HTML-এ chart-এর ওপরে শিরোনাম, অথবা ব্রাউজারে আঁকা interactive chart, যেখানে লেখা ব্রাউজারই সাজায় (পর্ব ৩১)।
১০ · AI-এর যুগে matplotlib
“বিক্রির একটা bar chart বানিয়ে দাও” বললে AI সহকারী কয়েক সেকেন্ডে কোড দেয়, আর সাধারণত সেটি চলেও। সমস্যা হলো, chart চললেই ঠিক নয়। ভুল অক্ষ, হারানো একক, ভুল ঘরে শিরোনাম বা বানানো parameter চোখে না দেখলে ধরা পড়ে না। matplotlib-এর ২০ বছরের বেশি সময়ের কোড ইন্টারনেটে ছড়ানো, তাই AI প্রায়ই পুরোনো ধরন আর নতুন ধরন মিশিয়ে ফেলে।
| AI প্রায়ই যা করে | কী হয় | কীভাবে ধরবেন |
|---|---|---|
plt.title আর ax.set_title মিশিয়ে লেখে | শিরোনাম ভুল Axes-এ, বা TypeError | এক chart-এ এক ধরন; ছবিতে প্রতিটি লেখা মিলিয়ে দেখা |
পুরোনো style নাম, যেমন "seaborn" | OSError | plt.style.available দেখা |
অস্তিত্বহীন method বা parameter বানায় (set_xlabels) | AttributeError বা চুপচাপ উপেক্ষা | নিজের সংস্করণের docs; চালিয়ে দেখা |
| “বাংলা ফন্ট দিলেই হবে” বলে | 3.10-এ যুক্তাক্ষর ভাঙে | সংস্করণ দেখা; ছবি বড় করে চোখে যাচাই |
সতর্কবার্তা লুকাতে warnings.filterwarnings("ignore") | হারানো glyph বা ভুল ডেটার খবর চাপা পড়ে | সতর্কবার্তা পড়া, কারণ ঠিক করা |
| একক, উৎস আর “simulated” লেখা বাদ দেয় | পাঠক ভুল বোঝেন | অক্ষের লেবেলে একক, caption-এ উৎস |
AI-কে chart চাইলে ডেটার গঠন, সংস্করণ আর নিয়ম স্পষ্ট করে বলুন, আর আসল ডেটার বদলে কলামের নাম ও কয়েকটি বানানো সারি দিন:
AI-এর বানানো chart হাতে পেলে — যাচাইয়ের চেকলিস্ট
আরও গভীরে: Anscombe-এর ধারণাকে চরমে নিয়েছেন Justin Matejka আর George Fitzmaurice, ২০১৭ সালের CHI সম্মেলনের “Same Stats, Different Graphs” প্রবন্ধে: simulated annealing দিয়ে বিন্দু একটু একটু সরিয়ে তাঁরা একই গড়, variance আর correlation রেখে ডাইনোসর, বৃত্ত আর তারার মতো আকার বানিয়েছেন (“Datasaurus Dozen”). matplotlib-এর নকশার মূল কথা পাওয়া যায় John Hunter-এর ২০০৭ সালের প্রবন্ধে, আর artist-এর গাছ নিয়ে বিস্তারিত আছে matplotlib docs-এর “Artist tutorial”-এ। Text shaping-এর জন্য OpenType-এর বাংলা লিপির নিয়ম (Microsoft-এর “Developing OpenType Fonts for Bengali Script”) আর HarfBuzz-এর docs পড়লে বোঝা যায় কেন কাজটি এত জটিল।
পরীক্ষা ও ইন্টারভিউতে:
- Figure আর Axes-এর পার্থক্য? Figure পুরো ক্যানভাস; Axes তার ভেতরের একটি plot, যার নিজের দুটি Axis আছে।
plt.plotআরax.plot-এর পার্থক্য? প্রথমটি pyplot-এর “বর্তমান Axes”-এ আঁকে, দ্বিতীয়টি নির্দিষ্ট Axes-এ।- figsize (8, 4.5), dpi 150-এ PNG কত pixel? ৮ × ১৫০ = ১২০০ চওড়া, ৪.৫ × ১৫০ = ৬৭৫ উঁচু;
bbox_inches="tight"দিলে এটি বদলাতে পারে। - ছাপার জন্য কোন format? PDF বা SVG (vector); raster লাগলে উঁচু dpi-র PNG.
- Anscombe's quartet কী শেখায়? একই সারাংশ পরিসংখ্যানের ডেটাও সম্পূর্ণ আলাদা হতে পারে; মডেলের আগে ছবি দেখুন।
ভাবনার প্রশ্ন
প্রতিটি প্রশ্ন নিয়ে নিজে কিছুক্ষণ ভাবুন — তারপর “→ উত্তর” চাপুন।
প্র ০১Anscombe ১৯৭৩ সালে চারটি ছোট ডেটাসেট দিয়ে কী প্রমাণ করতে চেয়েছিলেন, আর আজকের মেশিন লার্নিংয়ে সেই শিক্ষা কেন আরও জরুরি?
Anscombe-এর সময়ে কম্পিউটার ছিল দামি আর ধীর, আর পরিসংখ্যানের প্রচলিত ধারণা ছিল: সংখ্যার হিসাব নিখুঁত, ছবি আঁকা মোটা দাগের কাজ। তাঁর প্রবন্ধের মূল দাবি ছিল উল্টো: কম্পিউটারের উচিত হিসাবের পাশাপাশি ছবিও আঁকা, কারণ ছবি দেখায় হিসাবের অনুমান (assumption) আদৌ খাটে কি না। চারটি ডেটাসেটের প্রতিটি একটি আলাদা ফাঁদ: Set I-এ সরলরেখা ঠিক, Set II-এ সম্পর্কটি বাঁকা, Set III-এ একটি outlier ঢাল বদলে দেয়, Set IV-এ একটিমাত্র বিন্দু পুরো correlation তৈরি করে। চারটিতেই linear regression একই উত্তর দেয়, কারণ regression শুধু গড় আর variance-এর মতো কয়েকটি যোগফল দেখে।
২০১৭ সালে Matejka আর Fitzmaurice দেখান যে একই পাঁচটি সারাংশ সংখ্যা রেখে প্রায় যেকোনো আকার বানানো যায়, এমনকি একটি ডাইনোসর। মানে Anscombe-এর উদাহরণ দুর্লভ কাকতালীয় ঘটনা নয়, এটি নিয়ম।
মেশিন লার্নিংয়ে এটি আরও জরুরি, কারণ মডেল হাজার হাজার কলাম আর লাখো সারি নিয়ে কাজ করে, আর একটি accuracy সংখ্যা ছাড়া প্রায় কিছুই দেখায় না। বাজারঘরের ডেলিভারির ডেটায় যদি কোনো জেলার সব মান ভুল করে মিনিটের বদলে ঘণ্টায় লেখা থাকে, গড় সামান্য বদলাবে, কিন্তু histogram-এ দুটি আলাদা চূড়া চোখে পড়বে। ডেটার ভুল একক, ডুপ্লিকেট, ভুল label, এক জায়গায় জমে থাকা মান (যেমন ফর্মের default 0) প্রায়ই প্রথম ধরা পড়ে একটি সাধারণ chart-এ। আবার মডেলের ভুল, যেমন residual-এ কোনো নকশা থাকা, ছবিতেই দেখা যায়, সংখ্যায় নয়। তবে উল্টো ফাঁদও আছে: ছবি দেখে নকশা “খুঁজে পাওয়া” সহজ, যা আসলে কাকতালীয়; তাই ছবি প্রশ্ন তোলে, উত্তর দেয় পরীক্ষা আর পরিসংখ্যান (পর্ব ৩৭)।
মূল উপলব্ধি: সারাংশ সংখ্যা আর ছবি একে অপরের পরিপূরক। মডেলের আগে ডেটার ছবি, আর মডেলের পরে ভুলের ছবি দেখার অভ্যাস অনেক নীরব বাগ বাঁচায়।
প্র ০২matplotlib-এ দুই রকম interface কেন আছে? pyplot-এর state machine কি একটি ভুল নকশা ছিল?
ইতিহাস দিয়ে বুঝলে সহজ। John Hunter ২০০৩ সালের দিকে matplotlib শুরু করেন এমন বিজ্ঞানীদের জন্য, যাঁরা MATLAB-এ plot(x, y), title('...') লিখে অভ্যস্ত। MATLAB-এর ধরন ছিল একটি “বর্তমান figure” মনে রাখা, কারণ interactive কাজে সেটি স্বাভাবিক: আপনি একটি জানালায় একটি chart দেখছেন, আর পরের কমান্ড সেখানেই যাবে। pyplot সেই অভিজ্ঞতা Python-এ এনেছিল, আর তাতেই matplotlib দ্রুত জনপ্রিয় হয়; MATLAB থেকে আসা মানুষের নতুন কিছু শিখতে হয়নি।
কিন্তু ভেতরে matplotlib শুরু থেকেই object-oriented: Figure, Axes, Line2D সবই class, আর pyplot শুধু একটি পাতলা আবরণ, যা “বর্তমান” বস্তু খুঁজে তার method ডাকে। plt.title("x") আসলে plt.gca().set_title("x"). যখন মানুষ একটি figure-এ ছয়টি ঘর, ফাংশনের ভেতরে chart, সার্ভারে লুপে হাজারটি রিপোর্ট বানাতে শুরু করলেন, তখন লুকানো state সমস্যা হয়ে দাঁড়াল: কোন ফাংশন কোন figure বদলাচ্ছে বোঝা যায় না (এক ধরনের hidden state), দুটি থ্রেড একই “বর্তমান” ব্যবহার করলে গোলমাল, আর বন্ধ না করা figure মেমরি খায়।
তাই এটি ভুল নকশা নয়, বরং একটি trade-off: দ্রুত, ছোট, interactive কাজে implicit ধরন কম লেখায় কাজ সারে; বড়, পুনঃব্যবহারযোগ্য কোডে explicit ধরন পরিষ্কার। সফটওয়্যারে এই টানাপোড়েন সব জায়গায়: global variable বনাম parameter, “magic” framework বনাম স্পষ্ট কোড। Python-এর নিজের দর্শনে (“The Zen of Python”) একটি লাইন আছে, “Explicit is better than implicit”; matplotlib-এর docs-ও আজ জটিল chart-এ explicit ধরন সুপারিশ করে, যদিও pyplot-কে সরায়নি, কারণ লাখো script তার ওপর নির্ভর করে।
মূল উপলব্ধি: একটি লাইব্রেরির নকশা বোঝা যায় তার ইতিহাস জানলে। pyplot সুবিধার জন্য, object-oriented API নিয়ন্ত্রণের জন্য; দুটি চিনে রাখুন, কিন্তু এক chart-এ মেশাবেন না।
প্র ০৩একটি গবেষণাপত্র, একটি ওয়েবসাইট আর একটি WhatsApp বার্তার জন্য একই chart কোন format আর কোন dpi-তে সংরক্ষণ করবেন, আর কেন?
প্রশ্নটি আসলে “ছবিটি কোথায়, কোন মাপে, কে দেখবে?” Raster ছবিতে তথ্য একটি নির্দিষ্ট pixel grid-এ আটকে যায়; vector ছবিতে থাকে আঁকার নির্দেশ, যা দেখার মুহূর্তে যেকোনো মাপে আবার আঁকা হয়।
গবেষণাপত্র বা ছাপা রিপোর্ট: সাধারণত PDF (LaTeX-এ সরাসরি বসে) বা অনেক পত্রিকার ক্ষেত্রে vector-এর অন্য format. ছাপায় লেখা আর রেখা তীক্ষ্ণ থাকে, আর PDF-এ ফন্ট ভেতরে ঢোকানো থাকে, তাই অন্য যন্ত্রে খুললেও একই দেখায়। অনেক পত্রিকা raster চাইলে নির্দিষ্ট dpi বলে দেয়, প্রায়ই ৩০০ বা তার বেশি; নির্দেশিকা দেখে নেওয়াই নিয়ম। লাখো বিন্দুর scatter হলে rasterized=True, নইলে PDF খুলতেই সময় লাগে।
ওয়েবসাইট: ছোট, সহজ chart-এ SVG চমৎকার: যেকোনো স্ক্রিনে তীক্ষ্ণ, ফাইলও ছোট, আর CSS দিয়ে আকার বদলানো যায়। কিন্তু বিন্দু বেশি হলে SVG ফুলে ওঠে; লেখকের run-এ একটি সাধারণ histogram-এও SVG (২৫ KB) PNG-এর (১৩ KB) প্রায় দ্বিগুণ ছিল। তখন PNG, আর আধুনিক ফোনের উচ্চ-ঘনত্বের স্ক্রিনের কথা ভেবে দেখানোর মাপের প্রায় দ্বিগুণ pixel (dpi ১৫০–২০০), সঙ্গে HTML-এ width আর height. ওয়েবে বাংলা লেখা দরকার হলে ছবির বাইরে HTML-এ রাখা আরও একটি সুবিধা দেয়: সার্চ আর screen reader দুটোই পড়তে পারে।
WhatsApp বা Messenger: এগুলো ছবিকে নিজের মতো সংকুচিত করে, প্রায়ই JPEG-এ; SVG বা PDF ছবি হিসেবে দেখায়ই না। তাই PNG, মাঝারি dpi, বড় ফন্ট আর মোটা রেখা, কারণ পাঠক ছোট স্ক্রিনে দেখবেন। chart-এ JPEG নিজে বেছে নেবেন না: সাদা পটভূমিতে লেখা আর রেখার কিনারায় ঝাপসা দাগ পড়ে।
মূল উপলব্ধি: একটি “সেরা” format নেই। গন্তব্য, মাপ আর পাঠকের যন্ত্র দেখে format আর dpi বাছুন, আর chart বানানোর কোড রেখে দিন, যাতে প্রয়োজনে যেকোনো format-এ আবার বানানো যায়।
প্র ০৪বাংলা লেখা ঠিকমতো দেখানো এত কঠিন কেন, আর matplotlib-এ এটি আসতে ২০২৬ পর্যন্ত লাগল কেন?
ইংরেজিতে একটি অক্ষর মানে প্রায় সব সময় একটি glyph, বাঁ থেকে ডানে পাশাপাশি। বাংলা একটি abugida জাতীয় লিপি: ব্যঞ্জনের সঙ্গে স্বরচিহ্ন জোড়ে, আর সেই চিহ্ন বসতে পারে আগে (ি, ে, ৈ), পরে (া, ী), নিচে (ু, ূ, ৃ) বা দুই দিকে (ো, ৌ)। Unicode এগুলো রাখে উচ্চারণের ক্রমে, তাই “কি” লেখা হয় ক, তারপর ি; দেখানোর সময় ি-কে সরিয়ে আগে আনতে হয়। তার ওপর যুক্তাক্ষর: হসন্ত দিয়ে জোড়া ব্যঞ্জন কখনো একটি সম্পূর্ণ নতুন glyph (ক্ষ), কখনো ফলা (ক্র, ক্য), কখনো ছোট করা প্রথম অক্ষর। কোন জোড়া কীভাবে দেখাবে তা ফন্টের ডিজাইনারের সিদ্ধান্ত, যা OpenType-এর নিয়মের টেবিলে লেখা থাকে। Shaping engine সেই নিয়ম পড়ে প্রয়োগ করে।
এই engine বানানো বড় কাজ। HarfBuzz প্রায় দুই দশক ধরে উন্নত হয়েছে, Behdad Esfahbod-সহ অনেকের হাতে, আর আজ বড় ব্রাউজার আর অনেক অপারেটিং সিস্টেম এটি ব্যবহার করে; এজন্যই ব্রাউজারে বাংলা ঠিক দেখায়। matplotlib-এর নিজস্ব লেখা আঁকার পথ তৈরি হয়েছিল তারও আগে, সরাসরি FreeType দিয়ে glyph নিয়ে; HarfBuzz জুড়তে হলে লেখা মাপা, লাইন ভাঙা, mathtext, PDF আর PS-এ ফন্ট ঢোকানো, সব কিছুর হিসাব বদলাতে হয়, আর আগের সব ছবির pixel বদলে যায়, যা হাজারো test ভাঙে। একটি স্বেচ্ছাসেবী-চালিত প্রকল্পে এমন কাজ বছরের পর বছর লাগতে পারে; মাঝের সময়ে mplcairo-র মতো আলাদা প্রকল্প Raqm দিয়ে সমাধান দিয়েছে, কিন্তু সেটি আলাদা ইনস্টলের ঝামেলা ছিল। 3.11-এর ঘোষণা নিজেই বলে, সব সুবিধা এখনো আসেনি।
আমাদের জন্য শিক্ষা দুটি। এক, “বাংলা সমর্থন” মানে শুধু ফন্ট নয়; ফন্ট, shaping, লাইন ভাঙা আর ইনপুট, সব স্তরে কাজ লাগে, আর প্রতিটি নতুন টুলে (PDF লাইব্রেরি, গেম ইঞ্জিন, ছোট ডিভাইসের স্ক্রিন) প্রশ্নটি নতুন করে করতে হয়। দুই, কম সম্পদের ভাষার সমস্যা প্রায়ই সমাধান হয় যখন কেউ নির্দিষ্ট ভুলের উদাহরণসহ রিপোর্ট করেন আর পরীক্ষা করেন; বাংলাভাষী ডেভেলপাররা খোলা উৎসের প্রকল্পে test case আর ছবি দিয়ে বড় অবদান রাখতে পারেন।
মূল উপলব্ধি: বাংলা লেখা ঠিক দেখানো একটি পুরো প্রযুক্তির স্তূপের কাজ। নতুন কোনো টুল “বাংলা সমর্থন করে” দাবি করলে নিজে ি, ে, র-ফলা আর ক্ষ দিয়ে পরীক্ষা করুন।
প্র ০৫seaborn, Plotly, Excel আর AI-এর বানানো chart থাকতে matplotlib শেখার মূল্য কী?
প্রথম কারণ ভিত্তি। seaborn প্রতিটি chart আঁকে matplotlib-এর Axes-এ, আর ফেরত দেয় সেই Axes বা Figure; pandas-এর .plot-ও তাই। seaborn-এর একটি chart-এর শিরোনাম, tick বা ফাইল সংরক্ষণ বদলাতে গেলে আপনি আসলে matplotlib লিখছেন। Figure, Axes আর artist-এর ধারণা না থাকলে এই কাজ অন্ধের মতো চেষ্টা-ভুল হয়ে দাঁড়ায়। Plotly আলাদা লাইব্রেরি, ব্রাউজারে আঁকে, আর interactive কাজে ভালো (পর্ব ৩১); কিন্তু গবেষণাপত্র, ছাপা রিপোর্ট আর স্থির ছবির বেশির ভাগ Python কাজে matplotlib আজও প্রচলিত।
দ্বিতীয় কারণ পুনরুৎপাদনযোগ্যতা। Excel-এ ক্লিক করে বানানো chart-এর ধাপ কোথাও লেখা থাকে না; ডেটা বদলালে আবার হাতে বানাতে হয়, আর কেউ জানে না কোন সারি বাদ পড়েছিল। কোডে লেখা chart একটি রেসিপি: নতুন মাসের ডেটা এলে একই script চালালেই নতুন ছবি, আর Git-এ (পর্ব ১২) দেখা যায় কে কবে কী বদলেছে। AI কাজের ধারায় এটি জরুরি, কারণ একই chart বারবার বানাতে হয়: প্রতিটি training run-এর loss, প্রতিটি মডেলের confusion matrix.
তৃতীয় কারণ যাচাই। AI সহকারী chart-এর কোড দ্রুত লেখে, কিন্তু অংশ ১০-এর টেবিলে দেখেছেন, সে পুরোনো API, ভুল Axes, বানানো parameter দেয়। কোড পড়ে বলতে পারা “এই শিরোনাম ভুল ঘরে যাবে” বা “এই formatter একক হারিয়েছে” তখনই সম্ভব, যখন আপনি গঠনটি বোঝেন। তবে সীমাও স্বীকার করা দরকার: matplotlib-এর API বড় আর পুরোনো, অনেক কাজের তিন-চারটি উপায় আছে, আর সাধারণ পরিসংখ্যানের chart-এ seaborn কম কোডে ভালো ফল দেয়। তাই পেশাদার পথ প্রায়ই মিশ্র: seaborn বা pandas দিয়ে আঁকা, matplotlib দিয়ে সাজানো আর সংরক্ষণ।
মূল উপলব্ধি: matplotlib হলো Python-এর chart জগতের ব্যাকরণ। প্রতিদিন হয়তো সরাসরি সব লিখবেন না, কিন্তু যে টুলই ব্যবহার করুন, শেষ পর্যন্ত এর ভাষাতেই ঠিক করবেন আর যাচাই করবেন।
অনুশীলন
উপরের কোড ব্লকগুলো বদলে নিজে চালিয়ে দেখুন; তারপর উত্তর মিলিয়ে নিন।
-
লাখের নিয়মে টাকা (কোড আর হিসাব): অংশ ৪-এর bar chart-এ y-অক্ষের লেখা “Tk 1,00,000” রূপে (বাংলাদেশের লাখ-কোটির নিয়ম) দেখানোর জন্য একটি ফাংশন লিখুন আর
FuncFormatterদিয়ে বসান। হাতে হিসাব করে বলুন, ঢাকার ৫,৯৭,৫৮৮ টাকা আর ১২৩৪৫৬৭৮ টাকা আপনার ফাংশনে কী হবে।নিয়ম: শেষ তিন অঙ্ক একসঙ্গে, তার আগে প্রতি দুই অঙ্কে কমা।
from matplotlib.ticker import FuncFormatter

def lakh(v, pos=None):
    s = str(int(round(v)))
    head, tail = s[:-3], s[-3:]
    parts = []
    while len(head) > 2:
        parts.insert(0, head[-2:])
        head = head[:-2]
    if head:
        parts.insert(0, head)
    return "Tk " + ",".join(parts + [tail])

ax.yaxis.set_major_formatter(FuncFormatter(lakh))
৫৯৭৫৮৮: tail = 588, head = 597 → parts = [5, 97] → “Tk 5,97,588”. ১২৩৪৫৬৭৮: tail = 678, head = 12345 → 45, তারপর 23, তারপর 1 → “Tk 1,23,45,678”, মানে ১ কোটি ২৩ লাখ ৪৫ হাজার ৬৭৮। ছোট মান, যেমন 0, সোজা “Tk 0”. matplotlib formatter-কে দুটি জিনিস দেয়, মান
vআর tick-এর ক্রমpos; তাই ফাংশনের দুটি parameter. ঋণাত্মক মান এই সংস্করণ সামলায় না; চাইলে চিহ্ন আলাদা করে নিন। -
আউটপুট অনুমান করুন: চালানোর আগে লিখে ফেলুন কী ছাপা হবে, তারপর মিলিয়ে নিন।
fig, axes = plt.subplots(2, 3, figsize=(8, 4.5), dpi=150)
print(axes.shape, len(fig.axes))
ax = axes[1, 0]
ax.plot([1, 2], [3, 4])
ax.plot([1, 2], [4, 3])
print(len(ax.lines), len(axes[0, 0].lines))
print(fig.get_size_inches() * fig.dpi)
fig2, one = plt.subplots()
print(type(one).__name__)
(2, 3) 6 2 0 [1200. 675.] Axes২ × ৩ grid মানে ৬টি Axes, array-র shape
(2, 3). দুটি রেখাইaxes[1, 0]-এ, মানে দ্বিতীয় সারির প্রথম ঘরে; প্রথম সারির প্রথম ঘর খালি। pixel = ইঞ্চি × dpi: ৮ × ১৫০ = ১২০০, ৪.৫ × ১৫০ = ৬৭৫; ফল float array. আর ১ × ১ হলেsubplotsarray নয়, সরাসরি একটি Axes ফেরত দেয়; তাইone[0]লিখলে error আসবে। (লেখক matplotlib 3.11.2-এ পুরো কোডটি চালিয়ে এই চারটি লাইনই পেয়েছেন।) -
সমালোচনা ও নতুন নকশা: একজন সহকর্মী AI দিয়ে একটি রিপোর্টের chart বানিয়েছেন। কোডে
plt.titleআরax2.set_xlabelমেশানো; শিরোনাম বাংলায় “মাসিক বিক্রি”, আর matplotlib 3.10-এ ছবিতে “মাসকি বকি্রি” দেখাচ্ছে; y-অক্ষ শুরু ৯০,০০০ থেকে; কোনো একক নেই; পাঁচটি জেলা লাল-সবুজের কাছাকাছি রঙে; ছবি JPEG, dpi 72, ছাপা রিপোর্টে বসানো। কী কী সমস্যা, আর আপনি কীভাবে নতুন করে বানাবেন?- মেশানো interface:
plt.titleযাবে “বর্তমান” Axes-এ, যা হয়তো ax2 নয়। পুরোটাfig, (ax1, ax2) = plt.subplots(...)আরax.set_*-এ লিখুন। - ভাঙা বাংলা: 3.10-এ shaping নেই। ছবির শিরোনাম ইংরেজিতে (“Monthly sales”) আর বাংলা শিরোনাম রিপোর্টের caption-এ; অথবা 3.11+ আর বাংলা ফন্ট দিয়ে বানিয়ে চোখে যাচাই।
- y ৯০,০০০ থেকে: bar chart-এ bar-এর দৈর্ঘ্যই তুলনা, তাই সামান্য পার্থক্যও বিশাল দেখায়।
ax.set_ylim(0, ...); পার্থক্যই বিষয় হলে line বা dot chart. - একক নেই:
ax.set_ylabel("Sales (taka)")আর টাকার formatter. - লাল-সবুজ রং: বর্ণান্ধ পাঠক আলাদা করতে পারবেন না;
tab10বাtableau-colorblind10, আর সম্ভব হলে সরাসরি bar-এর পাশে নাম। - JPEG, dpi 72: ছাপায় ঝাপসা আর কিনারায় দাগ।
fig.savefig("sales.pdf")বা ৩০০ dpi-র PNG,bbox_inches="tight".
শেষে caption-এ উৎস আর “simulated” বা আসল ডেটার সময়কাল লিখুন।
- মেশানো interface:
-
Anscombe নিয়ে পরীক্ষা: অংশ ১-এর কোডে Set IV থেকে (১৯, ১২.৫০) বিন্দুটি সরিয়ে দিন (দুই তালিকা থেকেই অষ্টম মান)। কী হবে বলে মনে হয়? চালিয়ে দেখুন, আর ব্যাখ্যা করুন।
বাকি দশটি বিন্দুর x সবই ৮, তাই x-এর variance ০। Correlation-এর সূত্রে x-এর standard deviation দিয়ে ভাগ করতে হয়, মানে ০ দিয়ে ভাগ;
np.corrcoefফল দেয়nan. লেখকের যন্ত্রে (NumPy 2.5.4) এর সঙ্গেRuntimeWarning: invalid value encountered in divideএসেছে; পাতার ভেতরের Python-এ WebAssembly-র কারণে এই সতর্কবার্তা না-ও আসতে পারে, তাইnan-টিই আসল সংকেত। সবচেয়ে কাছের রেখা এখানে একটি খাড়া রেখা, যার ঢাল অসীম; লেখকের run-এnp.polyfitতবু দুটি সংখ্যা (০.৪৩৮, ৩.৫০; মানে ৮ × ০.৪৩৮ + ৩.৫০ ≈ ৭.০০, বাকি দশটি y-এর গড়) ফেরত দিয়েছে, সঙ্গেRankWarning: Polyfit may be poorly conditioned; মানে সংখ্যাগুলো অর্থহীন, আর সতর্কবার্তাটিই আসল খবর। শিক্ষা: Set IV-এর r = ০.৮১৭ পুরোপুরি একটি বিন্দুর ওপর দাঁড়িয়ে ছিল। বাস্তবে একটি outlier সরিয়ে বা যোগ করে ফল কতটা বদলায় দেখা একটি ভালো পরীক্ষা, আর ছবি না দেখলে এই ভঙ্গুরতা ধরা পড়ত না।
নিজেকে যাচাই করুন
ভুল হলে কারণসহ ব্যাখ্যা পাবেন, আবার চেষ্টাও করতে পারবেন।
ক্রমobject-oriented ধরনে একটি chart বানিয়ে সংরক্ষণের ধাপগুলো সঠিক ক্রমে সাজান (▲▼ চেপে সরান)
fig, ax = plt.subplots(figsize=(6, 3.5))— Figure আর Axes তৈরিax.bar(...)বাax.plot(..., label=...)— ডেটা আঁকাax.set_title,ax.set_ylabel, formatter — লেখা আর এককax.legend()— label থেকে legendfig.savefig("chart.png", dpi=150)— ফাইলে লেখাplt.close(fig)— মেমরি ছাড়া
matplotlib-এ “Axes” বলতে কী বোঝায়?
- পুরো ছবির ক্যানভাস
- Figure-এর ভেতরের একটি plot-এর ঘর, নিজের দুটি অক্ষসহ
- শুধু x-অক্ষ
- রং আর ফন্টের default সেটিং
একটি কোডে লেখা আছে plt.subplot(1, 2, 1); plt.plot(x, y); plt.subplot(1, 2, 2); plt.title("B"). শিরোনাম “B” কোথায় বসবে?
- বাঁ ঘরে, যেখানে রেখা আঁকা হয়েছে
- পুরো Figure-এর ওপরে
- ডান ঘরে, কারণ শেষ “বর্তমান” Axes সেটি
- কোথাও না, error আসবে
figsize (৬, ৩.৫) ইঞ্চির একটি figure dpi=200 দিয়ে PNG হিসেবে সংরক্ষণ করলে (bbox_inches ছাড়া) ছবির আকার কত pixel?
- ১২০০ × ৭০০
- ৬০০ × ৩৫০
- ৩৩ × ৫৭
- dpi PNG-এ কোনো প্রভাব ফেলে না, তাই আগের মতোই
একটি ডেটাসেটের গড়, variance আর correlation আরেকটির প্রায় সমান। এ থেকে সবচেয়ে সঠিক সিদ্ধান্ত কোনটি?
- দুটি ডেটাসেট মূলত একই
- দুটির জন্যই একই linear মডেল সমান ভালো কাজ করবে
- কোনোটিতে outlier নেই
- আকার আলাদা হতে পারে, তাই দুটিরই ছবি দেখা দরকার
matplotlib 3.10-এ Noto Sans Bengali ফন্ট সেট করে শিরোনামে “জেলাভিত্তিক বিক্রি” লিখলে ছবিতে কার-চিহ্ন ভুল জায়গায় বসে আর যুক্তাক্ষর ভাঙে। মূল কারণ কী?
- ফন্টে বাংলা অক্ষর নেই
- matplotlib 3.10 complex text shaping (ি-কার সরানো, যুক্তাক্ষর জোড়া) করে না
- Python ফাইলের encoding ভুল
- dpi কম
ax = monthly.plot(kind="bar") চালানোর পর ax কী?
- একটি PNG ফাইলের পথ
- বদলে যাওয়া DataFrame
- একটি matplotlib Axes, যা আরও সাজানো যায়
- একটি matplotlib Figure
একটি chart ছাপা গবেষণাপত্রে যাবে, আর যেকোনো মাপে লেখা তীক্ষ্ণ থাকা দরকার। কোন format সবচেয়ে উপযুক্ত?
- PDF (vector)
- JPEG
- dpi 72-এর PNG
- GIF
শব্দকোষ
লেখার মধ্যে ডটেড দাগ দেওয়া শব্দে মাউস রাখুন বা চাপুন — অর্থ দেখাবে। এই পর্বের সব নতুন শব্দ এখানে একসাথে:
মনে রাখুন
- একই গড়, variance আর correlation-এর ডেটা সম্পূর্ণ আলাদা হতে পারে (Anscombe, ১৯৭৩); মডেলের আগে ছবি।
- Figure ক্যানভাস, Axes একটি plot-এর ঘর, Axis একটি অক্ষ, আর আঁকা সবকিছু artist.
fig, ax = plt.subplots()তারপরax.set_*; pyplot-এর “বর্তমান Axes”-এর সঙ্গে এক chart-এ মেশাবেন না।- tick-এ একক ও কমা দিতে
matplotlib.ticker; কয়েকটি ঘরেsubplots(nrows, ncols, sharex=...)আরlayout="constrained";df.plotএকটি Axes ফেরত দেয়। - pixel = ইঞ্চি × dpi; ছাপায় PDF/SVG, ওয়েবে PNG/SVG. বাংলা লেখা matplotlib 3.11+ আর বাংলা ফন্টে ঠিক আসে; পুরোনো সংস্করণে ছবিতে ইংরেজি, বাংলা caption-এ।
আরও পড়ুন · ABCL TECH-এ আপনার পরবর্তী পদক্ষেপ
- পর্ব ২৯ · কোন chart কখন — distribution, তুলনা, সম্পর্ক আর সময়পরবর্তী পর্বপ্রশ্ন থেকে chart: distribution, তুলনা, সম্পর্ক, অংশ আর সময়ের জন্য ঠিক ছবি।
- AI-এর ভিত্তি আর Python for AI · কোর্স হোম৭৯টি পর্বপুরো কোর্সের রোডম্যাপ; পরের পর্ব ২৯ · কোন chart কখন — distribution, তুলনা, সম্পর্ক আর সময়।
- পর্ব ২৪ · Groupby আর aggregationআগের ভিত্তিchart-এ যাওয়ার আগে জেলা আর মাস ধরে যোগফল।
- পর্ব ৮ · Jupyter notebookআগের ভিত্তিcell-এর নিচে chart, magic command আর kernel-এর লুকানো state.
- পর্ব ১৮ · ছবি মানেই arrayপাশের বিষয়raster ছবির pixel, channel আর
imshow. - Python · ডেটা সায়েন্সের প্রথম ধাপঝালাইPython কোর্সে NumPy আর pandas-এর সংক্ষিপ্ত পরিচয়।